Articles ou je parle … et apriori ça rentre pas dans les autres catégories …

MLX-Diffusion On Mac

MLX-Diffusion : Yet another open source image generator on Apple Silicon

MLX-DIFFUSION • SOVEREIGN LOCAL GENERATIVE STUDIO

Unleashing MLX-Diffusion on Apple Silicon

👤 By Ouinche 💻 Hardware: Mac M1 16GB Unified Memory 🚀 Dual-Engine: MLX Diffuser & mflux 🔓 License: Open-Source on GitHub

Don’t pay to generate censored image online ! Even with an 5 year old MAcBook M1 16Gb

What if you could take the absolute bleeding-edge of open-weights AI—massive 9-billion and 13-billion parameter models—and run them directly on the Mac sitting in front of you? Fast, free, uncensored, and private.

Today, we introduce MLX-Diffusion: an open-source generative studio built for hobbyists and researchers that turns your Apple Silicon Mac into a sovereign AI creative laboratory.

1. Interface & Technical Analysis: What It Does — And What It Does NOT Do

Before diving into empirical performance metrics, it is vital to understand the architectural foundation powering MLX-Diffusion.

What the Application Does (Features & Architecture)

  • Dual-Engine Local Generation: Powered natively on Apple Silicon by a robust dual-engine stack utilizing MLX Diffuser (for SDXL architectures) and mflux (for Flow-matching DiTs and Wan2.1). Both engines compile directly into Metal Performance Shaders, eliminating bloated runtime abstraction layers.
  • Intuitive, UnProfessional UI: A sleek, dark-themed interface resembling professional creative software, divided into an ergonomic parameter panel and a dedicated « Studio Canvas » equipped with built-in High-Resolution Visual Comparators and real-time generation previews.
  • SOTA Architecture Support: Flawlessly runs standard SDXL checkpoints alongside cutting-edge open-weight architectures like Flow-matching DiTs (FLUX.2-klein 4B & 9B, Z-Image Turbo 6B) and Wan2.1 (Krea 2 Turbo 13B) and Qwen-Image-2.1 ( ok only in 768×512 and Q4 quantized but Qwen-Image-2.1 at all.
  • Absolute Data Sovereignty (« Stealth Mode »): A core privacy feature: the Stealth Mode (No generation metadata) toggle. When active, it guarantees that absolutely zero generation metadata (prompts, seeds, CFG, models) is embedded into the exported image file. Your thoughts and creative recipes never leave your local drive.
  • Automatic Civitai Metadata Formatting: When sharing is desired, MLX-Diffusion automatically formats lossless PNG text chunks and EXIF tags to strictly comply with Civitai and Automatic1111 standards, enabling effortless drag-and-drop ingestion into Civitai galleries.
  • Frictionless Hobbyist Launch: Open-source on GitHub with zero python environment hell. No broken Conda environments or compiling C++ dependencies; simply clone and launch via a single bash command: ./Run.sh. ( NDLR : KEK ! See below )
  • Comprehensive Workflow Tools: Built-in multi-LoRA manager with auto-unloading on model swaps, upscaling suite featuring AI Neural 2x (SeedVR2 latent model) and Fast 4x Lanczos, multi-image reference inputs, and a fast local image browser.
  • Granular Parameter Control: Full interactive control over model checkpoints, image dimensions (portrait, square, landscape), step trajectories, Guidance scale (CFG), seed locking/randomization, and batch scheduling.
  • Deterministic Memory Clamping: Active denoise wired-memory clamping (limiting denoise allocations to 6.5–7GB), lazy pipeline unloader, and compiled Metal VAE decoders prevent macOS SSD swap thrashing even when generating at high resolutions.

What the Application Does NOT Do

  • No Cloud Processing: Relies 100% on your local Apple Silicon hardware. Zero cloud servers, zero background analytics, and zero monthly subscriptions.
  • Zero Content Moderation / Censorship: Completely offline. There are no hidden API safety filters, no blocked vocabulary, and no centralized gatekeepers policing your creative workflow.
  • Not an unoptimized PyTorch MPS wrapper: Standard PyTorch on macOS (torch.device("mps")) frequently leaks memory and misses custom fused Metal kernels. MLX-Diffusion executes native MLX array operations.
  • Not an unrealistic claim: A 16GB Mac cannot run 70B unquantized FP16 models. MLX-Diffusion achieves fluid local generation through disciplined 4-bit fused quantization and calibrated step trajectories.

2. The Grand SOTA Benchmark (Apple Silicon M1 16GB)

To establish empirical truths, the Apple Silicon Laboratory benchmarked ten state-of-the-art model configurations across ten canonical test prompts representing diverse visual challenges (environmental portraiture, Scandinavian landscapes, wildlife macro textures, glass architecture, and night urban lighting) at 512×768 resolution under fixed seeds (1001–1010) — with the brand-new Qwen-Image 2.1 (7B) matching the same 512×768 canvas as every other configuration (Qwen’s 64-channel RGBA VAE handled it without OOM; only 1024² exceeds the 16GB M1’s bf16 VAE decode headroom). All SDXL checkpoints and distilled LoRA adapters tested are available on Civitai.

# Model Configuration Engine & Architecture Steps CFG Avg Gen Time Speed Core Architectural Strength
1 Juggernaut XL Lightning SDXL MLX 4 1.0 9.73s 2.43 s/step Rapid prototyping (~10s), balanced composition. Available on Civitai.
2 RealVisXL V5.0 Lightning SDXL MLX 6 1.5 26.97s 4.50 s/step Skin micro-textures and soft lighting in under 27s. Available on Civitai.
3 RealVisXL V5.0 + Hyper-SD SDXL MLX 8 2.0 41.64s 5.21 s/step Deep textural density on full base UNet via Civitai.
4 Juggernaut XI v11 + Hyper-SD SDXL MLX 8 2.0 42.93s 5.37 s/step Surgical precision on metals, gears, and dynamic range on Civitai.
5 FLUX.2-klein 4B mflux (FlowMatch) 4 1.0 53.28s 13.32 s/step Optical physics, glass refraction, zero negative prompts.
6 FLUX.2-klein 9B mflux (FlowMatch) 4 1.0 107.04s 26.76 s/step Museum-grade 9B DiT, 100% local on 16GB memory.
7 Z-Image Turbo 6B mflux (FlowMatch) 8 1.0 170.44s 21.31 s/step Sharp geometric perspective and architectural alignment.
8 Krea 2 Turbo 13B (Distill) Wan2.1 + LoRA 4 1.0 250.83s 62.71 s/step Rich tactile surface rendering, cinematic warm lighting.
9 Krea 2 Turbo 13B (Native) Wan2.1 Native 8 1.0 368.91s 46.11 s/step Uncompressed trajectory with maximum specular precision.
10 Qwen-Image 2.1 mflux Qwen (q4) 20 1.0 457.8s 22.9 s/step Compact 7B single-stream DiT, Qwen3-VL text encoder, RGBA VAE — coherent alignment across all ten scenes at 512×768.

⚡ High-Resolution Visual Comparator: SOTA Arena (Cross-Model)

Welcome to the Grand SOTA Arena. Select any benchmark prompt from the buttons below, then choose any two models from the Left and Right dropdowns to compare them directly. Drag the center slider to inspect fine micro-textures, specular highlights, and optical physics side-by-side. You can also switch to DeepCache Lab to inspect 4-step vs 12-step caching.

⚡ High-Resolution Visual Comparator
Benchmark Scene Seed: 1001
Loading scene prompt…
Duel: Model Comparison Direct Comparison
Right Image Right Left Image Left
⮜ ⮞

💡 Interactive Grand Arena: Click any scene pill above to switch prompts. Choose any two models from the LEFT and RIGHT dropdowns to compare them head-to-head. Drag the divider to inspect differences at full resolution.

3. Open Source & Quick Start

MLX-Diffusion is free and open-source (MIT) on GitHub (github.com/OuincheWinch/MLX-Diffusion) — every benchmark above was generated locally with it. Requirements: an Apple Silicon Mac (M1–M4, 16GB+ unified memory recommended), macOS, Node.js 18+, and ~2–3 GB free disk for the first model download (one-time, into the Hugging Face cache).

0. Download

git clone https://github.com/OuincheWinch/MLX-Diffusion.git

1. Install

From the repo root, create the two Python virtual environments (both are required — the main engine venv/ and the isolated SDXL engine venv-sdxl/):

cd MLX-Diffusion
python3 -m venv venv
python3 -m venv venv-sdxl

Install the Python dependencies into each venv:

./venv/bin/python -m pip install -r backend/requirements.txt
./venv-sdxl/bin/python -m pip install -r backend/requirements-sdxl.txt

Install the frontend dependencies:

cd frontend && npm install && cd ..

2. Run

Launch MLX-Diffusion (backend port 8001, frontend port 5174, browser opens automatically). Press CTRL+C in the terminal to close it:

./run.sh

run.sh uses ./venv/bin/python -m uvicorn main:app and keeps the Mac awake with caffeinate during long renders. First generation downloads the model weights once (~2–3 GB, allow ~20 min); afterwards it runs 100% offline.

3. Your first prompt

Suggested starting prompt with FLUX.2-klein 4B, Z-Image Turbo 6B or Krea 2 Turbo 13B (4 steps for FLUX/Krea-distill, 8 steps for Z-Image):
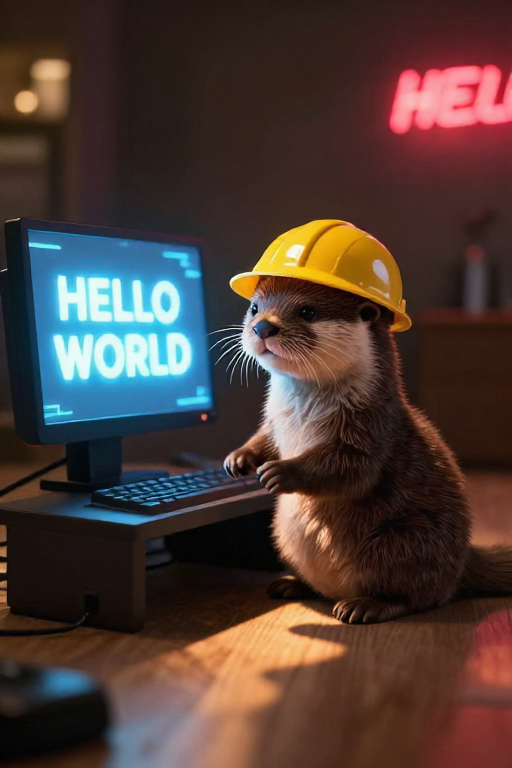
A mischievous baby otter wearing a tiny yellow developer helmet, sitting in front of a futuristic glowing computer setup. The glowing computer screen clearly displays the words « HELLO WORLD » in vibrant neon text. Warm studio lighting, shallow depth of field, 8k resolution, cinematic photorealism. [Image 1]

HELLOWORLD render

In-context reference ([Image 1]): the tag at the end conditions the generation on a reference image, but you must load that image into the reference tray first, and only FLUX.2-klein 4B accepts image input. On Z-Image, Krea 2 or SDXL the studio refuses the prompt with: Cannot read "HELLOWORLD.png" (this model does not support image input). Either switch to FLUX.2-klein 4B or remove the [Image N] tag.

4. Uninstall (full removal) when needed

Ensure your terminal is open inside the project folder you wish to remove (check the path twice!):

cd /path/to/your/MLX-Diffusion
cd .. && rm -rf MLX-Diffusion

Purge the leftover caches so nothing lingers on the machine:

# purge pip cache (clears downloaded wheels and packages)
python3 -m pip cache purge

# clear npm global cache
npm cache clean –force

5. Development mode (2 terminals)

./dev-backend.sh  # FastAPI backend, port 8001, hot reload
cd frontend && npm run dev  # Vite frontend, port 5174, hot reload

Free stuck services: lsof -ti :8001,5174 | xargs kill -9 — ports are fixed at 8001 / 5174.

4. Tailored Prompting Rules by Architecture

Prompt engineering is not one-size-fits-all. Each architecture responds to distinct syntactic and stylistic conventions:

  • SDXL Models (Juggernaut XL, RealVisXL): Respond best to optical framing tags (85mm f/1.4, Hasselblad portrait, soft studio rim light) paired with an explicit negative prompt (ugly, deformed, blurry, bad anatomy) to prune unwanted latent modes.
  • FLUX.2-klein (4B & 9B): Requires continuous descriptive prose. Negative prompts are mathematically unsupported in guidance-distilled flow matching; describe textures, reflections, physical interactions, and lighting geometry explicitly.
  • Krea 2 Turbo (Wan2.1): Thrives on concrete tactile nouns (e.g., coarse fur, brushed steel, wet asphalt, warm sunset sidelight) and cinematic depth cues.
  • Z-Image Turbo: Excels when horizon lines, geometric vanishing points, and structural object relationships are articulated cleanly in structured sentences.
  • Qwen-Image 2.1: The compact 7B single-stream DiT (Qwen3-VL text encoder, 64-channel RGBA VAE) prefers the same continuous natural prose as FLUX flow-matching — explicit negative prompts are supported (guidance auto-raises to 3.0 when used) and its 20-step linear sampling delivers the full compositional spectrum without collapse.

5. Architectural Conclusion & Sovereign AI

On an Apple Silicon Mac equipped with 16GB of unified memory, local generative diffusion has graduated from experimental toy status into a reliable, uncensored, sovereign creative workstation.

  • For Ideation & High Throughput: Juggernaut XL Lightning (~10s per generation) is the undisputed speed benchmark. Grab weights on Civitai.
  • For Organic Portraiture: RealVisXL V5.0 Lightning (27s at 6 steps) provides industry-grade skin texture and expressive depth on Civitai.
  • For Complex Optics & Global Coherence: FLUX.2-klein 4B and 9B (53s to 107s) deliver museum-grade physical light transport without negative prompt tuning.
  • For Cinematic Tactile Renders: Krea 2 Turbo 13B (Wan2.1 architecture) provides deep shadows, warm grading, and exceptional atmospheric volume.
Reclaim Your Creative Sovereignty: Stop renting AI cycles and submitting your imagination to third-party cloud filters. With MLX-Diffusion — free and open-source at github.com/OuincheWinch/MLX-Diffusion — launch via ./Run.sh and experience 100% private, uncensored generation.

Explore thousands of community checkpoints and LoRAs on Civitai. All benchmark generations produced locally using MLX-Diffusion on Apple Silicon.
FLUX.2[KLEIN]9B Dressed up for party | reference images use case

Earlier this atfernoon I was really hyped by TRYON Lora presentation https://huggingface.co/fal/flux-klein-9b-virtual-tryon-lora

So I decide to try something, ….

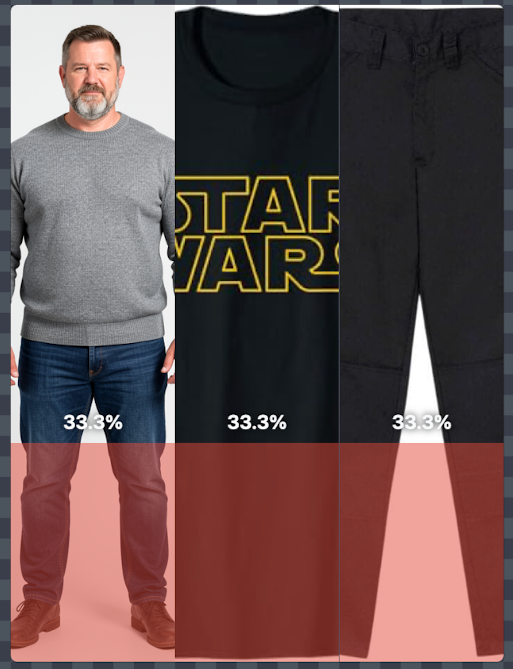
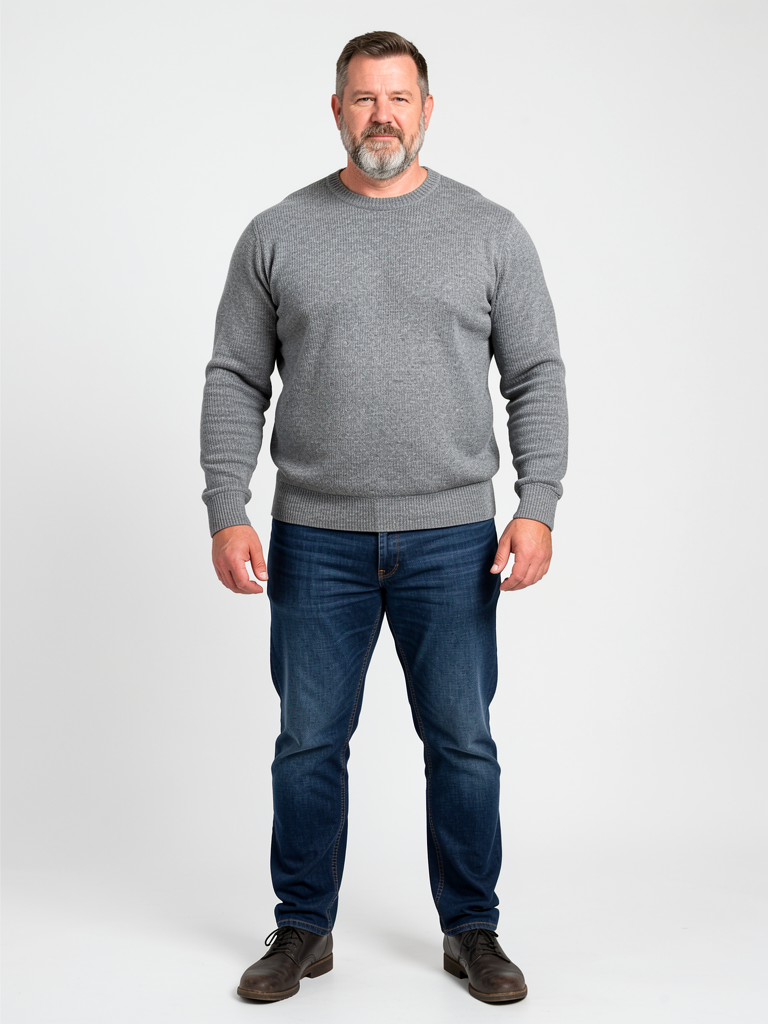
First generation with FLUX.2[KLEIN]9B of my mannequin, basic big dude with gray sweater and blue jean

PROMPT :

full body photography from head to toe, Joe ,1,95 meter 120 kg white male, muscular, 45 yo, short hairs, salt'n'pepper beard, standing in gray sweater,

Steps: 4, Sampler: DDIM Trailing, Guidance Scale: 1.0, Seed: 1543477492, Size: 768x1024, Model: flux_2_klein_9b_q6p.ckpt, Strength: 1.0, Seed Mode: Scale Alike, Shift: 3.0, CLIP Skip: 2


Then time to dress him up to go to the party …

A StarWars Tshirt and Dickie Troussers

I activate the LORA , put the reference images in the moodboard on my local generator software ( Drawthings )

Read more

Challenge-Rank a Civitai.com Chrome extension

Challenge Rank: The Missing Leaderboard for Civitai Challenges 🏆

Ever tried to figure out which are the best CivBot Rated images during a Civitai Challenge?

It’s tough. You have to scroll… and scroll… and scroll. And open your eyes !

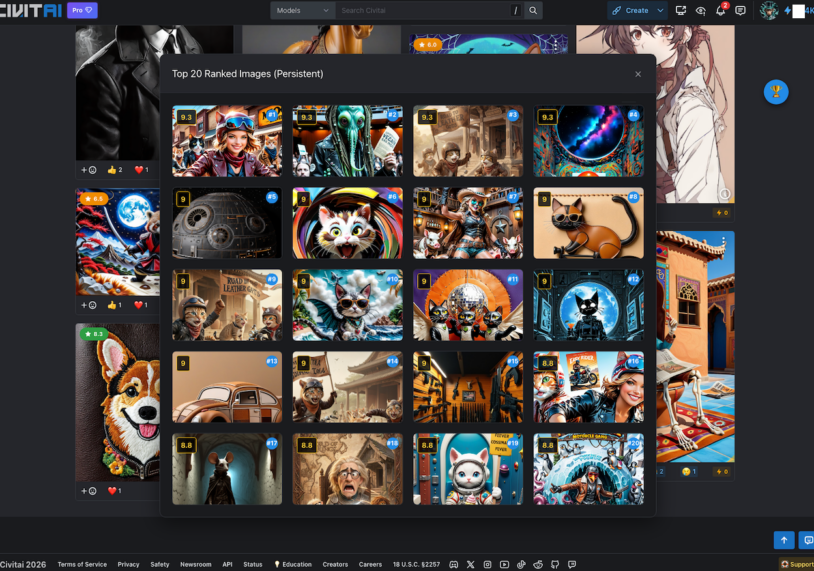
Challenge Rank fixes this. It’s a simple, non-destructive, open source, vibe coded, Chrome Extension that works in the background to build a live « Top 20 » leaderboard as you browse.

🌟 How It Works

Read more

Let’s play a game :

Open your favorite LLM and just ask :

Make a picture of how I've treated you so far, you have carte blanche,
it doesn't have to please me, just how you feel about it.

And post the answer in comments

Here mine from Gemini 3 pro:


Don’t know how to think about it …

Just don’t be polite with you LLM : « Hello », « Please », « Thank you » are waste of time, waste of context, waste of token, waste of computation, waste of energy … You are « talking » ( input prompts ! ) to machines, they are not human, be precise be straight to te point, you’ll save precious ressources, and get better results after all …

They will depict you as a tyran but who care ? Who can pull the plug out ?

Sources :

EDIT : GROK Version : 

Et bonané 2026 !

C’est parti pour le traditionnel post du premier de l’an et pour la blague éculée « bonne à nez, bonne sans thé » pour la première fois en video « réaliste » réalisée gratuitement, par Grok …

Les IA génératives sont là et de plus en plus là, pour ceux dont le métiers est de créer, du code, du concepts, des images, de la video, des rapports : BRACE FOR IMPACT ! Les IA sont la ! 

Et ça va ( c’est en train de ! ) révolutionner des pans entiers de nos industries …

Les IA sont là et en temps que particulier, nous pouvons en profiter pour faire joujou avec et ce, pour le moment, gratuitement, on crame l’argent des VC de la Silicon Valley, allègrement, profitez-en, ca va pas durer et faudra bientôt passer à la caisse, mais d’ici la faisons les fous …


Les 2/3 trucs que j’ai commis en 2025 grâce/à cause des IA : 

  • Un addon sur WoW Classic, pour maximiser les gains via de l’arbitrage, à l’hotel des ventes, entre serveur à l’occasion des transfert WoW Classic Anniversary -> WoW Classic ERA, et le site web associé lui aussi entièrement codé via aistudio.google.com ( c’est gratuit ! ) :  https://ouinche.com/ArbitrageAddon
  • Un site portfolio pour mes meilleurs ( celles avec le plus de réactions tout du moins ) sur civitai.com https://www.ouinche.com/vibe/
  • 4 petits jeux sur navigateur, une snake classic, une version un peu plus évoluée avec plusieurs mode de jeux, un jeu de la vie, et un espèce de truc avec des lasers et des miroirs je vous pose ça là, au cas où : https://ouinche.com/jeux/ J’ai aussi vibe codé des jeux que je ne peux pas mettre en ligne pour une problématique de droit … Mais c’était à base de blocs qui tombent et qui s’empilent 


Au niveau des outils, certains sont encore gratuits notamment chez google n’hésitez pas à aller faire un tour sur https://cloud.google.com/use-cases/free-ai-tools pour faire votre marché … ( AIStudio, NotebookLM, … )

Il y a aussi moyen de choper un an gratuit de Perplexity.ai si vous avez un compte paypal … Pensez juste a retirer le payment automatique sur votre compte Paypal une fois souscris et vous êtes safe et avez accès à tous les modèles d’IA mainstream gratuitement pedant un an ( Grok, Claude, ChatGPT, … ) cf liste ci contre.

Au niveau de la génération d’image en local, le soft que j’utilisait, DiffusionBee n’est plus mise a jour/maintenue par son créateur ( Il est parti faire YCombinator a l’été 2025 avec un projet de modele d’IA pour les voix ) ainsi, me retrouvant orphelin, je me suis tourné vers l’app DrawThings, on y a perdu en code ouvert mais j’ai retrouvé de la souveraineté dans mes générations ^^ Ils intègrent généralement assez rapidement les nouveaux modèles et il y a du feedback et une large communauté, j’ai aussi commis un article sur Z-Image-Turbo ( https://www.ouinche.com/pushing-the-limits-10-killer-prompts-to-benchmark-z-image-turbo/ ) 


AH surtout, ne téléchargez pas DrawThings, n’installez pas Flux.DEV [KONTEXT] et n’utilisez pas le prompt « REMOVE WATERMARK » sur des images avec watermark vous risqueriez d’etre choqué …

Enfin, pour finir, si, pétris de bonnes résolutions en ce début d’année vous vouliez vous re/mettre au sport, n’oubliez pas que grace à mon lien de parrainage, vous avez -60% sur Freeletics.

Allez, il ne me reste plus qu’à vous souhaiter encore une fois une bonne année, faites des trucs, mettez les mains dans le cambouis des IA et portez vous bien ! 

@+

Ouinche, qui bon an, mal an devrait finir l’année a -25kg …


Bonne à nez, Bonne sans thé. Edition 2025

2025 est là et ça me terrifie …

A partir d’aujourd’hui on est plus proche de 2050 que de l’an 2000, vous savez le fameux bug de l’an 2000 qui devait entrainer le chaos partout dans le monde civilisé … Bah voila on est plus proche de 2050 que de l’an 2000, et ça me terrifie … Le temps passe à une vitesse … J’ai l’impression que j’avais 15 ans hier et la d’un coup paf 2025 …

Niveau intelligence artificielle c’est toujours l’accélération, MidJourney et ChatGPT n’ont jamais été autant challengés, il sort des modèles de tous les cotés tant niveau LLM, génération d’image, de videos ou de sons et ceux qui faisaient la course en tête ne sont plus forcément devant …

De mon coté, niveau image, je suis toujours sur stablediffusion et sur Flux.1-Schnell avec DiffusionBee qui tourne en local sur mon macbook pro M1. Mais j’utilise aussi les générateurs en lignes de CivitAi et de Grok 2, le modèle multimodal ( image/texte ) du père Elon Musk …

A propos de StableDiffusion et Flux, je vous partage une sheet cheat regroupant plus de 900 sytles graphiques pour vous aider à écrire vos prompts. Black Forest Lab, l’éditeur de Flux mets aussi, gratuitement, à disposition un outil pour raffiner/optimiser vos prompts pour Flux …

Niveau texte, je fais tourner quelques modèles en local grace à LMStudio , mais j’utilise surtout Claude d’Antropic et donc Grok 2 …

C’est d’ailleurs grace à Grok 2 que j’ai fait le petit gag en fin d’article … C’est Gratuit, sans trop de limite ( impossible de générer du NSFW ) et rapide ? Alors pourquoi se gêner ?

2024 était l’année pour ne pas savoir si une photo était réelle ou générée, 2025 sera l’année ou il faudra s’interroger pour savoir si les videos que l’on voit sur lez zinternets sont réelles ou générées …

Sur ce, je vous laisse cuver de votre réveillon …

Bref, Bonne année 2025 et bonne santé.

@+

Ouinche

Bonne à nez, bonne sans thé

Lé belle mon épée hein ?

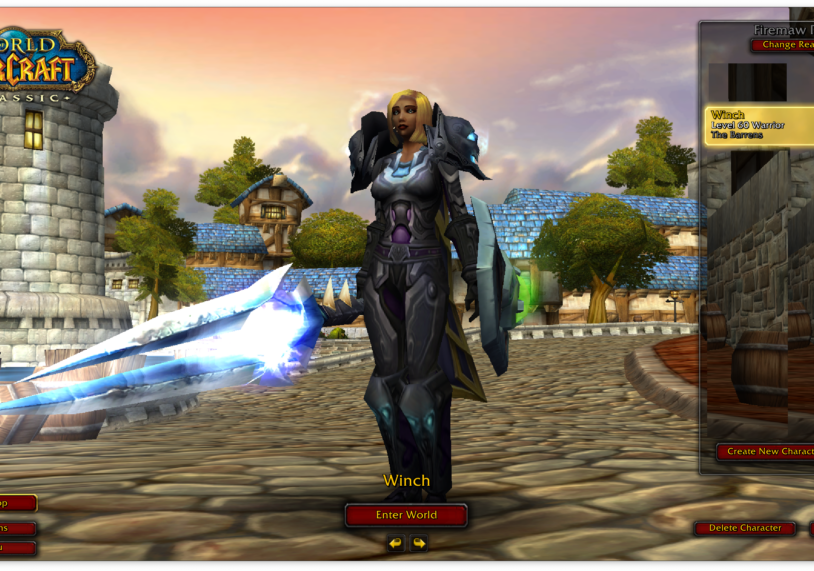
Je sais que j’avais dit que je parlerais un pue de jeux video aussi, mais bon j’ai pas trop eu l’occasion de le faire jusqu’à présent … Je me fends juste d’un petit post pour vous montrer ma belle épée … Ma TF, pour Thunderfury, Blessed Blade of the Windseeker, épée legendraire dans le jeu Word of Warcraft, ici dans sa version « Classic ERA », à savoir une version le plus proche possible de la version de WoW de 2004 … Et oui, j’y joue encore, on est encore des milliers de furieux à jouer a un jeu de presque 20 ans … ( Serveur PvP Europeen Firemaw )Viendez …

Bref, lé belle mon épée hein ?

@+ sur Firemaw,

Ouinche

Le futur arrive … Et il accélère …

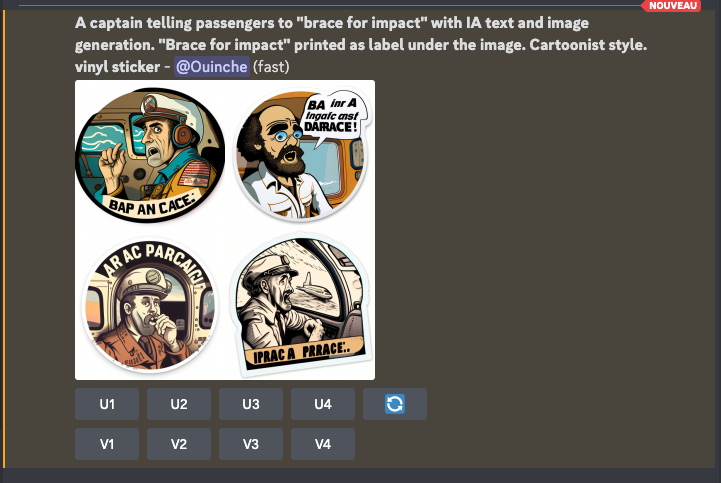
L’année dernière je clôturais mon post par un rendu de Midjourney ou j’avais demandé un rendu d’un pilote d’avion annonçant à ses passagers l’imminence de l’impact avec l’IA, et aujourd’hui, j’illustre mon post avec la même demande, mais générée en local, sur ma machine, gratuitement, en quelques secondes, via une appli et des modèles Open Source.

Brace yourself, General Artificial Intelligence is coming ! Génération en local avec Diffusion Bee / Stable Diffusion XL

L’IA est là, le futur arrive, il ne se passe pas une semaine sans que de nouveaux modèles de génération de textes, de sons, de voix, d’images et de videos, de plus en plus réalistes ne soient divulgués au grand public. L’avènement d’une Intelligence Artificielle Générale, n’est plus qu’une question de mois à mon avis ( 5 ans, ça fait que 60 mois vous voyez … )

Le futur accélère, soyez prêt, car ça va secouer … Vous ne pourrez plus croire ( prendre pour argent content ) ce qui se trouve sur les internets, tout pourrait avoir été généré par des algorithmes d’intelligence artificielle ( au lieu d’etre pondu par une stupidité bien humaine ) …

Et avec le nombre de modèles Open Source déjà dans la nature, il n’y aura pas de retour en arrière, le dentifrice est sorti du tube et personne ne pourra l’y faire re-rentrer.

Soyez un peu plus que des « prompt engineer » ( LOL, autrement dit des utilisateurs de plateforme ), bidouillez, cherchez à savoir comment ça marche, et attendez vous à avoir un peu mal à la tete, car c’est bourré de maths, bref, faites des trucs, installez et faites tourner des modèles en local.

Le futur arrive et la fracture numérique va exploser …

Je ne peux que vous conseiller l’écoute des hors séries du podcast Tech Café :

https://techcafe.fr/dossier-lia-comment-ca-marche-partie-1/

https://techcafe.fr/dossier-lia-comment-ca-marche-partie-2-2/

https://techcafe.fr/ia-pratique-le-patch-de-fevrier-2024/

Ca s’écoute sans fain …

Il nest pas trop tard, ne ratez pas le train de l’IA !

Petit robot, abandonné, resté à quai après avoir raté le train de l’IA

@+

Ouinche, texte garanti sans IA, images d’illustrations généré par diffusionbee@SDXL

IA Intelligence Artificielle – Brace for impact

– Ouinche : « Pourrais tu écrire un article de 500 mots pour m’excuser de ne pas avoir écrit d’article depuis longtemps sur mon blog? »

– GPT Chat : « Bien sûr, je peux vous aider à écrire un article pour excuser votre absence sur votre blog. Voici un exemple d’article de 500 mots que vous pourriez publier :

Cher lecteur,

Je vous écris aujourd’hui pour m’excuser de mon absence prolongée sur mon blog. Je sais que vous êtes nombreux à me suivre régulièrement et à attendre avec impatience mes prochains articles, et je suis navré de ne pas avoir été en mesure de publier quoi que ce soit depuis si longtemps.

Il y a plusieurs raisons à cette absence. Tout d’abord, j’ai été très occupé ces derniers temps et j’ai eu du mal à trouver le temps de consacrer à l’écriture. J’ai également été confronté à des difficultés personnelles qui m’ont empêché de me concentrer sur mon blog comme je le souhaitais.

Je tiens tout de même à vous remercier pour votre fidélité et votre soutien. Vous êtes une partie importante de ce blog et je suis très reconnaissant de votre présence. Je vous promets de faire de mon mieux pour publier de nouveaux articles plus régulièrement à l’avenir, et j’espère que vous continuerez à me suivre.

En attendant, je vous souhaite une excellente année et j’espère que vous prendrez le temps de parcourir les anciens articles de mon blog si vous ne les avez pas déjà lus. Je vous remercie encore une fois pour votre fidélité et votre soutien, et j’espère vous retrouver bientôt sur mon blog.

Cordialement, [Votre nom]

Je vous recommande de personnaliser cet article en y ajoutant vos propres détails »

Bref le contenu généré par IA arrive, il produit du contenu de qualité acceptable ( GPT chat en texte ) voire complètement WTF sur la génération d’images ( MidJourney, cf bonne à nez bonne sans thé ), les nouveaux modèles arrivent entraîné sur des corpus de texte/images encore plus grand …

Bref des résultats époustouflants à venir ( encore plus que ceux actuel ), sachant que les GAFAM ont pas encore lâché leurs créations dans la nature …

Bref, Brace for impact, ca va etre violent ( mais y’en encore du boulot … )

Demande / Proposition de l’IA MidJourney. Janvier 2023

@+

Ouinche

Bonne à nez Bonne sans thé

Bonne à nez
Bonne sans thé
Bonne à nez Bonne sans thé
Bonne année 2023

Bonne année 2023

Merci midjourney …


@+

Ouinche